Neue KI-Modelle erscheinen laufend, mit einem Namen, einem Preis und einer Tabelle, die beweisen soll, dass das jeweilige Modell seinen Vorgänger überholt hat. Die Namen und die Preise kennen Sie vermutlich längst, auch wenn Sie nie ein Entwicklerwerkzeug geöffnet haben. Diese Zahlen beantworten die Frage des Anbieters. Sie beantworten nicht Ihre: wie Sie ein KI-Modell auswählen, das zu Ihrer Arbeit passt.
Behandeln Sie Aufgaben, die KI erledigen soll, wie jede andere Aufgabe in Ihrem Unternehmen. Wer eine Lieferung anbietet, ohne zu sagen, was ankommt, muss beantworten, was sich ändert und woran Sie erkennen, dass die Lieferung den Anforderungen entspricht; ein Preis pro Palette ohne Zusicherung, dass die Paletten unbeschädigt ankommen, hält das erste Gespräch nicht aus. Ein Modellangebot ohne klar beschriebenes Arbeitsergebnis ist genau ein solches Angebot: Namen, ein Preis pro Million Token (die Abrechnungseinheit der Anbieter) und die Zusage besserer Ergebnisse.
Eine Vertragsverlängerung macht es konkret, und dabei geht es um eine Entscheidung: wie es weitergeht, ob überhaupt mit einem neuen Modell gearbeitet wird. Die Frage lautet: „Sollen wir wechseln?“ Beantworten Sie sie anhand Ihrer eigenen Anforderungen: Nennen Sie eine wiederkehrende Aufgabe, nennen Sie die Person, die das Ergebnis dieser Aufgabe beurteilen kann, und fragen Sie, welcher Nachweis zeigen würde, dass eine andere Konfiguration dieselbe Aufgabe mindestens genauso gut erledigt. Die Eignung des Modells wird zur prüfbaren Vermutung, aus Ihrer eigenen Arbeit wird der Prüfstand. Jeder Abschnitt unten ist ein Schritt dieser Entscheidung: was als fertig gilt, was Sie vergleichen, was das Übungsbeispiel zeigt, was es kostet, was die Papiere offen lassen und was Sie mit ins Gespräch nehmen.
Erst festlegen, wann die Arbeit erledigt ist, bevor ein Modellname fällt
Eine Evaluation ist schlicht eine wiederholte Prüfung an typischen Fällen der eigentlichen Aufgabe. Keine Vorführung, keine fremde Testtabelle: Ihre Fälle, Ihr Material, Ihre Prüfregel. Typisch? Dazu gehören drei Gruppen von Fällen: die gewöhnlichen, die Ihr Team täglich sieht, die kniffligen, bei deren Bearbeitung Fehler auftreten, und die, die abgelehnt oder weitergereicht werden sollten, statt beantwortet zu werden. Anthropic empfiehlt in seiner Anleitung zu Evaluationen spezifische, messbare, erreichbare und relevante Kriterien und verlangt aufgabenspezifische Tests, die Sonderfälle einschließen: eine Empfehlung eines Modellherstellers, methodisch nützlich, aber kein unabhängiger Beleg (Anleitung). Für ein System, das Dokumente durchsucht, hat die Evaluation eigene Metriken und Werkzeuge (RAG-Evaluation: Metriken und Werkzeuge).
Was ist ein Prüfdatensatz? In diesem Zusammenhang kein Forschungsprojekt. Es ist die Sammlung der Prüffälle, an denen Sie die Kandidaten bewerten: Ihre eigenen Eingaben, die für jeden Fall akzeptierte Antwort und die Regel, die festlegt, welche Antworten die Prüfung bestehen.
Wie stellen Sie ihn zusammen, und wie ordnen Sie seine Aussagekraft ein? Ziehen Sie aktuelle Beispiele aus der Arbeit, wie sie wirklich läuft, auch die unordentlichen; die Person, die die Arbeit ausführt, bestätigt die akzeptierte Antwort je Fall; was Ihre Datenregeln verbieten, bleibt draußen. Verstehen Sie den Prüfdatensatz als Stichprobe, nicht als Beweis: Der Prüfdatensatz zeigt, ob zwei Kandidaten dieselbe Aufgabe unterschiedlich bearbeiten; für den Produktivbetrieb bescheinigt er nichts und über fremde Arbeit sagt er nichts.
Lässt sich der Ablauf in Schritte zerlegen, und was passiert in jedem? Sechs Schritte: festlegen, was als fertig gilt, Fälle sammeln, Prüfregel schreiben, alle Kandidaten mit denselben Fällen laufen lassen, abgenommene Ergebnisse und kritische Fehler zählen, dann entscheiden. Dieser Abschnitt umfasst die ersten drei.
Wenn KI den gesamten Ablauf durchläuft, prüfen Sie dann den ganzen Ablauf oder Stufe für Stufe? Prüfen Sie zunächst die einzelnen Stufen: Ändern Sie nur die Stufe, die Sie ändern wollen, und halten Sie den Rest gleich: Der komplette Lauf zeigt, ob das Endergebnis besteht, die Einzelprüfungen zeigen, wo es versagt. Wenn jede Stufe für sich besteht, prüfen Sie die Übergaben; danach prüfen Sie den gesamten Ablauf darauf, ob er das angestrebte Geschäftsergebnis liefert. Die Einzelprüfungen dienen der Diagnose; die Abnahme erfolgt erst, wenn der gesamte Ablauf die Prüfung besteht.
Wie gehen Sie dabei vor? Alles gleich halten außer der einen Sache, die Sie ändern: gleicher Prompt, dasselbe Material, dieselben Werkzeuge, dieselbe Prüfregel; Modellversion und Denkstufe (die Einstellung für den Rechenaufwand beim Schlussfolgern) je Durchlauf notieren; Abnahmekriterien festlegen, bevor Sie etwas ausführen; die Prüfzeit zusammen mit der Qualität erfassen, nicht erst danach. OpenAI sagt dasselbe (Modellwahl-Anleitung).
Drei Punkte vor dem Test, ohne die die Prüfung ins Leere läuft:
- Die abgenommene Einheit. Schreiben Sie die kleinste Leistung auf, die Sie tatsächlich bezahlen würden: ein geprüfter Datensatz, eine korrekt zugeordnete Anfrage, ein belegbarer Entwurf. Versuche zählen nicht als abgenommene Einheiten.
- Der erlaubte Weg. Welche Eingaben Ihr Haus verlassen dürfen und über welchen Dienst. Ein Modell, das auf einem unzulässigen Datenweg gut abschneidet, hat nichts bestanden.
- Die kritischen Fehler. Benennen Sie die Fehler, die die Arbeit blockieren, statt sie nur zu verzögern, und zählen Sie sie getrennt von den üblichen Ablehnungen.
Dazu gehört ein Blatt, das den Vergleich festhält: die für die Aufgabe verantwortliche Person, die bisherige Konfiguration als Vergleichsbasis (Baseline), die zu prüfende Konfiguration, die Qualitätsregel, die Prüfmethode, die Herkunft der Prüffälle, die Anzahl der abgelehnten und der angenommenen Fälle, die Dauer der menschlichen Prüfung in Minuten, die Gesamtkosten und der Auslöser für Eskalation oder Stopp. Zwei Warnungen: Die Schwellenwerte legt die für die Aufgabe verantwortliche Person anhand der Anforderungen ihres Prozesses fest, nie die Selbstsicherheit eines Modells; und ein kurzer Pilotversuch zeigt nur, was im Pilot passiert ist, nicht, dass ein seltenes Ereignis selten bleibt.
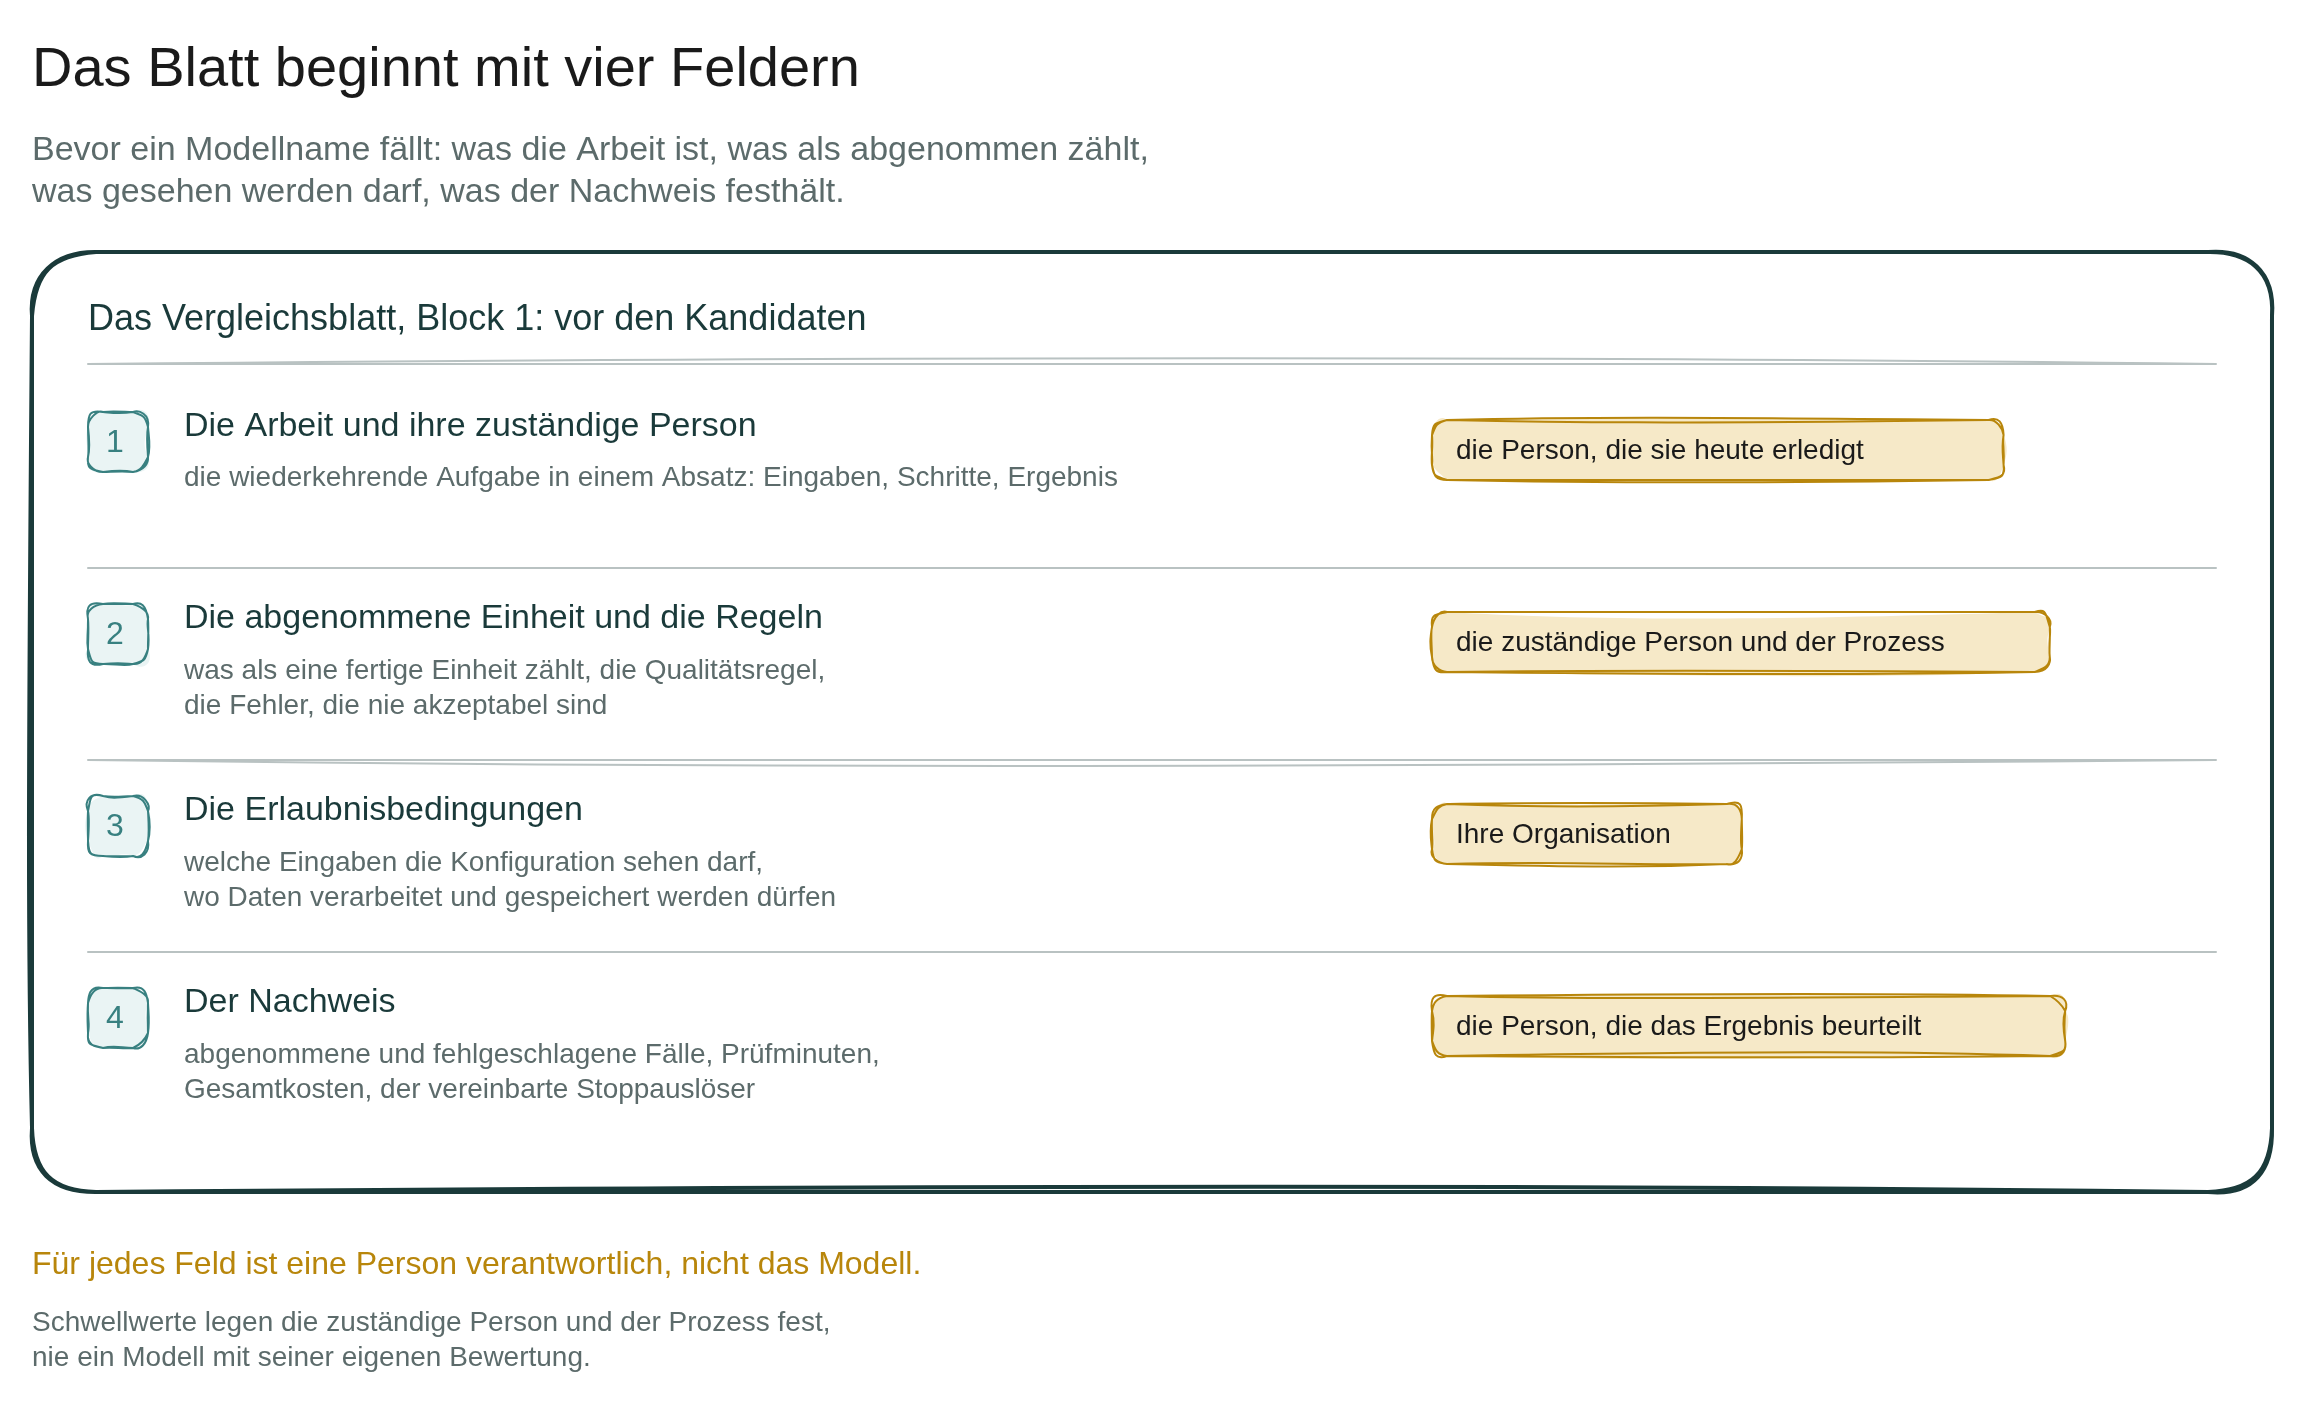 Der erste Block des Blatts: vier Felder, für jedes Feld ist eine Person verantwortlich. Bevor ein Modellname fällt, stehen Aufgabe, abgenommene Einheit, Erlaubnisse und erforderlicher Nachweis auf dem Papier.
Erst wenn diese Bedingungen stehen, lohnt sich der Vergleich von Kandidaten. Denn ein unzulässiger Datenweg wird nicht dadurch zulässig, dass ein Modell besser abschneidet.
Drei Konfigurationen im Vergleich, keine Rangliste
Drei Konfigurationen kommen infrage: eine leichte für klar umrissene Routineaufgaben, eine allgemein einsetzbare als bisherige Baseline, eine stärkere mit mehr Rechenzeit für komplexe Zusammenführungen von Informationen, bei denen eine Auslassung mehr kostet als die zusätzlich benötigten Token. Das sind Vermutungen, die Sie anhand Ihres eigenen Prüfblatts überprüfen, keine Kategorien, auf die Sie sich ungeprüft verlassen können.
Eine Konfiguration ist hier ein Modell samt Version und Denkstufe, dazu die Werkzeuge, die es benutzen darf, und die dafür erteilten Berechtigungen. Drehen Sie diese Regler einzeln: Ein Modellwechsel und eine Änderung der Denkstufe sind zwei verschiedene Experimente; wer beides zugleich ändert, kann die Wirkung der einzelnen Änderung nicht getrennt beurteilen. Halten Sie drei Wörter auseinander, die die Werbung gern zu einem Bündel schnürt: klein, offen, sicher. Keine dieser drei Eigenschaften garantiert eine der beiden anderen.
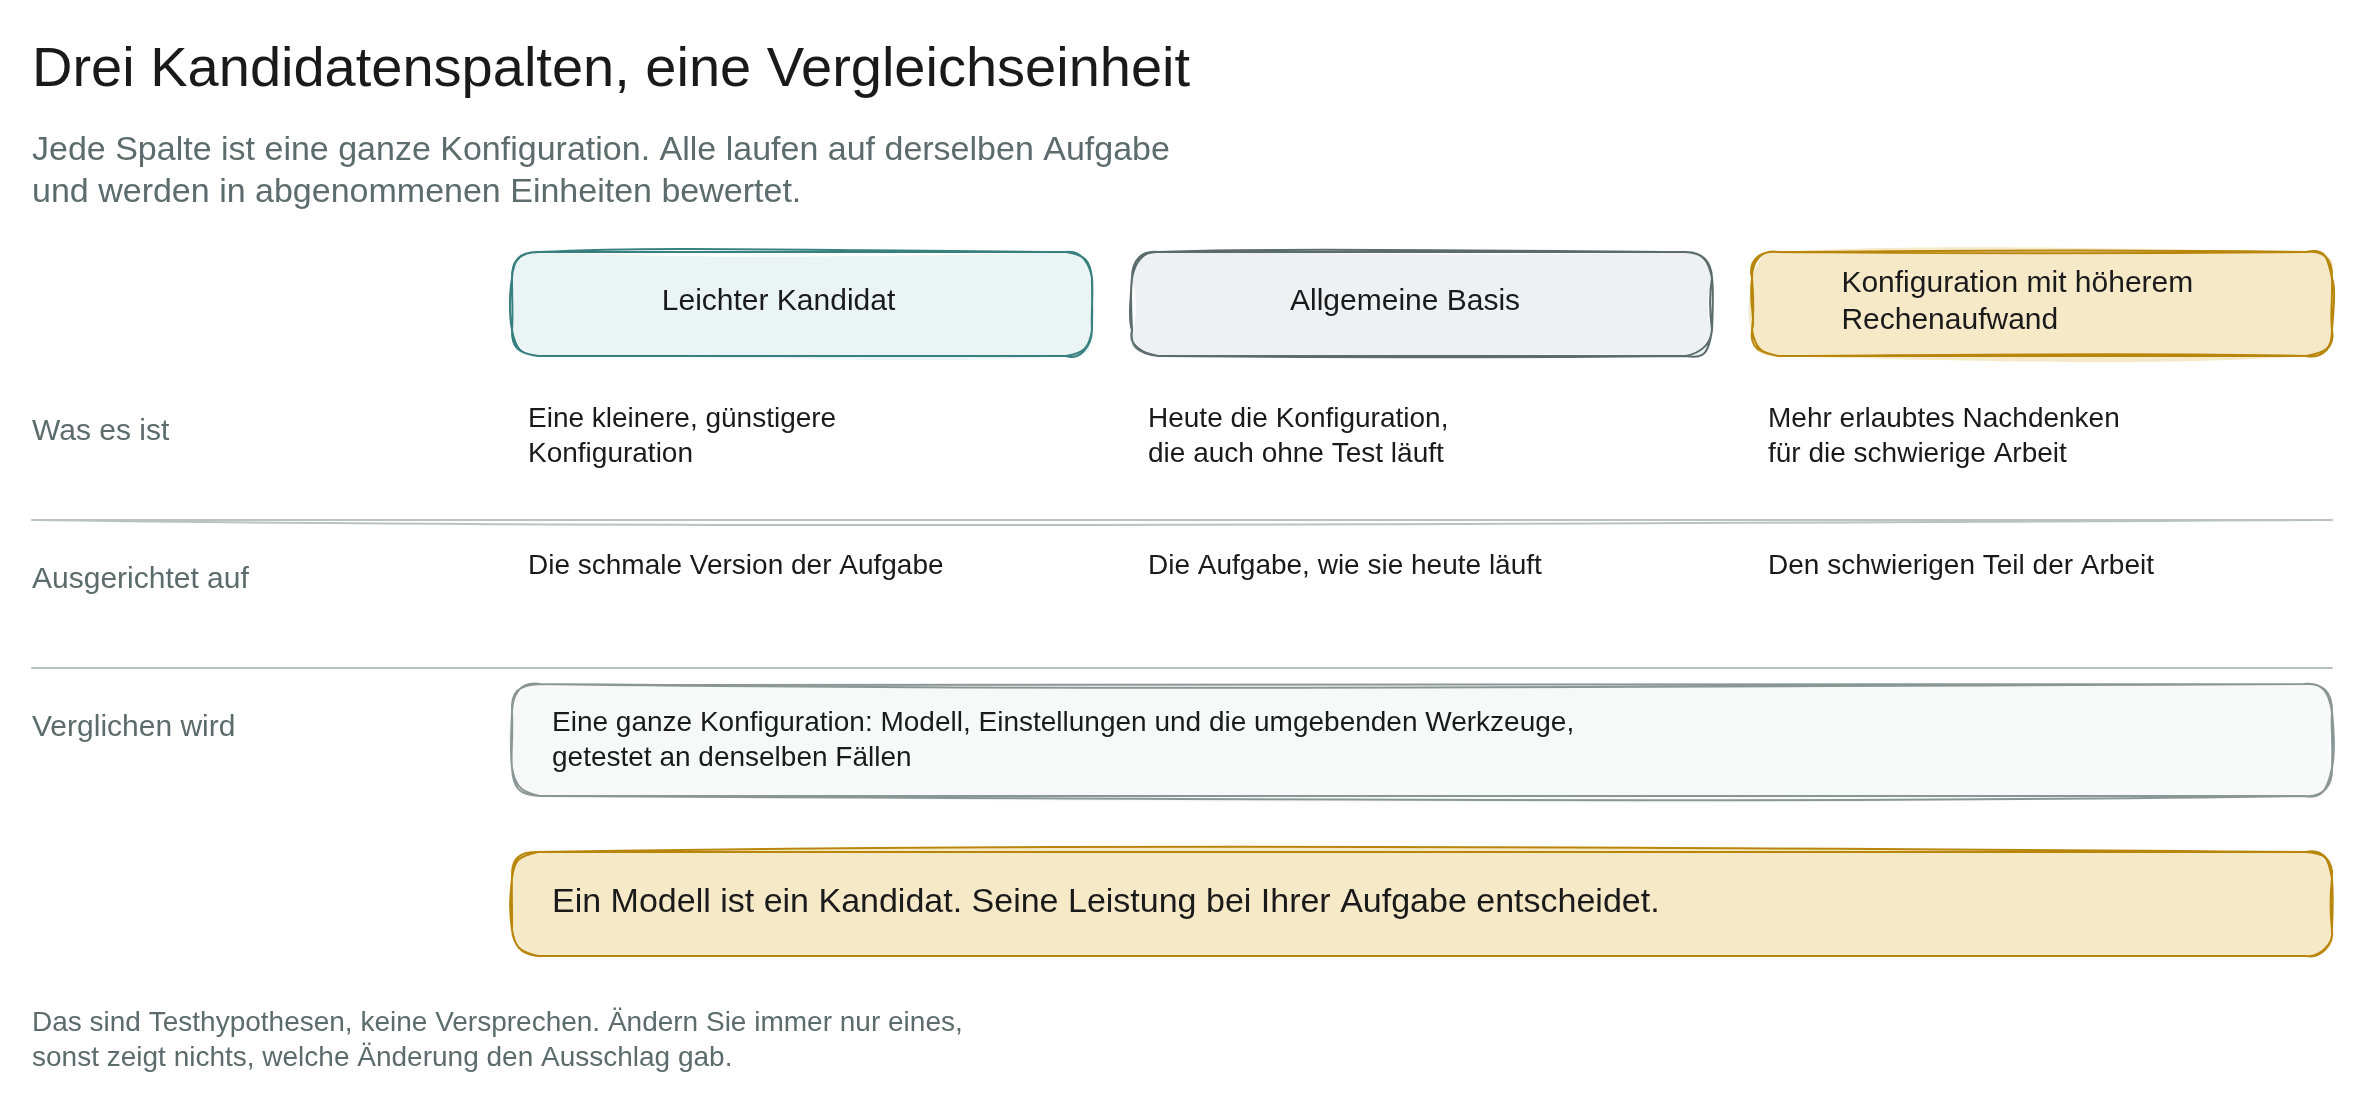 Drei Konfigurationen als Spalten eines Blatts. Jede Spalte ist eine ganze Konfiguration; alle bearbeiten dieselbe Aufgabe, verglichen wird in abgenommenen Einheiten.
Es gibt eine ältere Vorlage, und mehr nicht: Im Mai 2023 veröffentlichten Forschende FrugalGPT, eine Methode, die Modellkombinationen für verschiedene Anfragen wählt, um Kosten zu senken und die Genauigkeit zu verbessern (das Paper, eingereicht am 9. Mai 2023). Die Idee ist untersucht; die Zahlen des Papers sind drei Jahre alt, und keine Prozentzahl daraus überträgt sich auf Ihre Arbeit.
Was Sie mit den drei Konfigurationen tun, ist Führung, nicht Technik. Vergleichen Sie die leichte Konfiguration mit der jetzigen Baseline anhand derselben Fälle; danach entscheiden Sie: sie behalten, die Aufgabe aufteilen, für den schwierigen Teil einen stärkeren Kandidaten einsetzen oder stoppen. Kein Router, der Modellanfragen verteilt, kein neues Werkzeug, kein Codeprojekt ist nötig, um diesen Vergleich durchzuführen. Warum Ihre Investition auch bei einem künftigen Modellwechsel Bestand haben muss, beschreibt dieser Beitrag: KI-Investitionen, die Modellwechsel überleben.
Vier alltägliche Aufgaben auf einem Prüfblatt
Die Zeilen unten sind erdachte Prüfpläne, keine von evonomics oder einem Kunden erhobenen Ergebnisse und keine Resultate von Anbietermessungen oder Modelltests. Die Tabelle zeigt den Unterschied, auf den es ankommt: die Auswahl eines ersten Kandidaten gegenüber der Entscheidung, ihm die Aufgabe zu übertragen.
| Aufgabe / abgenommene Einheit | Konfiguration im Vergleich zur Baseline | Folgekosten und Risiko | Prüfung und Verantwortung | Eskalations- oder Stoppregel / geplante Entscheidung |
|---|---|---|---|---|
| Eine gewöhnliche eingehende Anfrage einer Abteilung zuordnen; abgenommene Einheit ist eine korrekt zugeordnete Anfrage ohne erfundene Anweisung. | Zuerst der leichte Kandidat, dann die bisherige Baseline. | Die falsche Warteschlange verzögert eine Antwort; mehrdeutige oder sensible Anfragen müssen anders behandelt werden. | Die verantwortliche Person der Abteilung nutzt repräsentative Anfragen mit vorab bekannter richtiger Zuordnung, einschließlich mehrdeutiger und abzulehnender Fälle, und notiert Fehler sowie Prüfminuten. | Anfragen mit unbekannter Kategorie oder fehlender Pflichtangabe gehen an eine Person. Die Baseline bleibt, wenn der leichte Kandidat die vereinbarten Anforderungen an die Zuordnung nicht erfüllt. Keine behauptete Ersparnis vor der Messung. |
| Bestellfelder aus einem bereitgestellten Beleg auslesen; abgenommene Einheit ist ein geprüfter Datensatz, kein Versuch des Auslesens. | Leichter Kandidat gegen die Baseline, mit denselben Belegen und demselben Feldschema. | Ein falscher Betrag, eine falsche Kennung oder ein fehlendes Feld verzögert die Bearbeitung der Folgeunterlagen. | Die für den Prozess verantwortliche Person gleicht die Felder mit der Quelle ab; Abweichungen in kritischen Feldern werden gesondert gezählt. | Ein Fehler in einem kritischen Feld blockiert den Folgeschritt und erfordert einen Blick in die Quelle. Aus der Übung unten folgt: Kandidat A ausschließen und B für einen weiteren kontrollierten Vergleich behalten; für den autonomen Betrieb folgt daraus keine Genehmigung. |
| Aus einem bereitgestellten Belegpaket einen Vergleich für die Geschäftsführung erstellen; abgenommene Einheit ist ein belegbarer Entwurf, bereit für die vorgesehene fachliche Prüfung. | Die Baseline gegen den stärkeren Kandidaten, mit demselben Paket und derselben Prüfregel. | Ein ausgelassener Punkt oder eine erfundene Tatsache verfälscht die Entscheidung; kürzerer Text ist kein Qualitätsmaß. | Die benannte fachkundige Person prüft Vollständigkeit, belegte Tatsachen und Vorbehalte und erfasst die Zeit für Prüfung und Nacharbeit. | Fehlende Belege oder ein ungeklärter Widerspruch führen zurück zur Quellenprüfung. Setzen Sie für den schwierigen Teil nur dann einen stärkeren Kandidaten ein, wenn der Vergleich es hergibt. |
| Eine Empfehlung aussprechen, die für eine Person oder eine verbindliche geschäftliche Zusage spürbare Folgen hat. | Ein Kandidatenmodell darf hier allenfalls einen abgegrenzten Vorbereitungsschritt unterstützen. | Folgen und erforderliche Befugnisse können bei der Entscheidung mehr wiegen als Leistungsfähigkeit und Preis. | Eine verantwortliche Person legt den erlaubten Nutzungsrahmen fest und prüft die Prozessbedingungen, bevor eine Ausgabe die Handlung beeinflusst. | Keine Modellstufe erlaubt die folgenreiche Handlung. Stoppen oder eingrenzen, wenn ein geregeltes Verfahren oder die nötige Befugnis fehlt. Diese Grenze muss die verantwortliche Führungskraft setzen. Das ist keine Rechtsberatung. |
Komplexität, Folgekosten, Betrieb und Modellstufe sind vier verschiedene Achsen in dieser Tabelle. Keine Stufe erlaubt für sich genommen autonomes Handeln.
Wann synthetische Daten nötig sind
Drei Situationen machen synthetische Daten unverzichtbar. Neues Produkt oder neuer Chatbot, noch keine Kundendaten: Erzeugen Sie zuerst eigene. Test vor dem Go-live, es muss klar sein, ob die Antworten stimmen: Erzeugen Sie synthetische Kunden, Verhaltensweisen und Profile als Testdaten. Der echte Datensatz ist vertraulich, Patienten- oder Kundendaten, die nicht herausgehen dürfen: Struktur und Format kennen Sie, also ersetzen Sie den Inhalt durch synthetische Daten mit derselben Struktur.
Die Eval-FAQ von Hamel Husain und Shreya Shankar sagt, wann synthetische Daten sinnvoll sind: Starten Sie die Fehleranalyse, bevor genug Produktionsdaten da sind, oder um einen Fehler zu testen, der mit echten Daten selten auftritt. Auch Husains früherem Evals-Beitrag empfiehlt: Warten Sie nicht auf Produktionsdaten, bevor Sie Ihr System prüfen; schätzen Sie, wie Nutzer arbeiten, und lassen Sie daraus Fälle erzeugen, das ist der Anfang. Dieselbe FAQ zieht auch die Grenze: Synthetische Fälle sagen nicht, wie oft ein Fehler in der Produktion vorkommt, also vergleichen Sie sie mit echten Daten, sobald echte Daten vorliegen.
Worauf es bei der Entscheidung ankommt: Schlägt das neue Modell das alte bei Qualität, Kosten und Tempo? Die Vergleichsgruppe bleibt klein: zwei Konfigurationen, dieselben 100 Bestellbelege, Kosten je abgenommenem Datensatz, Prüfminuten und eine vorher festgelegte Regel von mindestens 95 abgenommenen Fällen und keiner kritischen Abweichung. Was folgt, sind erfundene Testdaten; der Prüfstundensatz von 60 EUR ist eine angenommene Zahl, keine Empfehlung.
| Übungsbeispiel: Eingabe und Ergebnis | Kandidat A (leichte Konfiguration) | Kandidat B (Baseline) |
|---|---|---|
| Bearbeitete / abgenommene Fälle | 100 / 90 | 100 / 98 |
| Kritische Abweichungen | 1 | 0 |
| Sämtliche Modell- und Werkzeugkosten für den Lauf | 2 EUR | 8 EUR |
| Prüf- und Nacharbeitszeit zum angenommenen Satz von 60 EUR pro Stunde | 30 Minuten = 30 EUR | 10 Minuten = 10 EUR |
| Zugerechneter Kostenanteil für Einführung, Betrieb oder Wechsel in diesem Lauf | 0 EUR (ausdrücklich angenommene Vereinfachung) | 0 EUR (dieselbe Vereinfachung) |
| Laufkosten / Kosten je abgenommenem Datensatz, gerundet | 32 EUR / 0,356 EUR | 18 EUR / 0,184 EUR |
| Entscheidung nach der vorher festgelegten Regel von mindestens 95 abgenommenen Fällen und keiner kritischen Abweichung | Ausschluss für diese Aufgabe: Der Kandidat erfüllt die Qualitätsregel nicht, unabhängig vom Preis. | Erfüllt diese vorher festgelegte Regel; als Baseline für einen weiteren kontrollierten Vergleich behalten. |
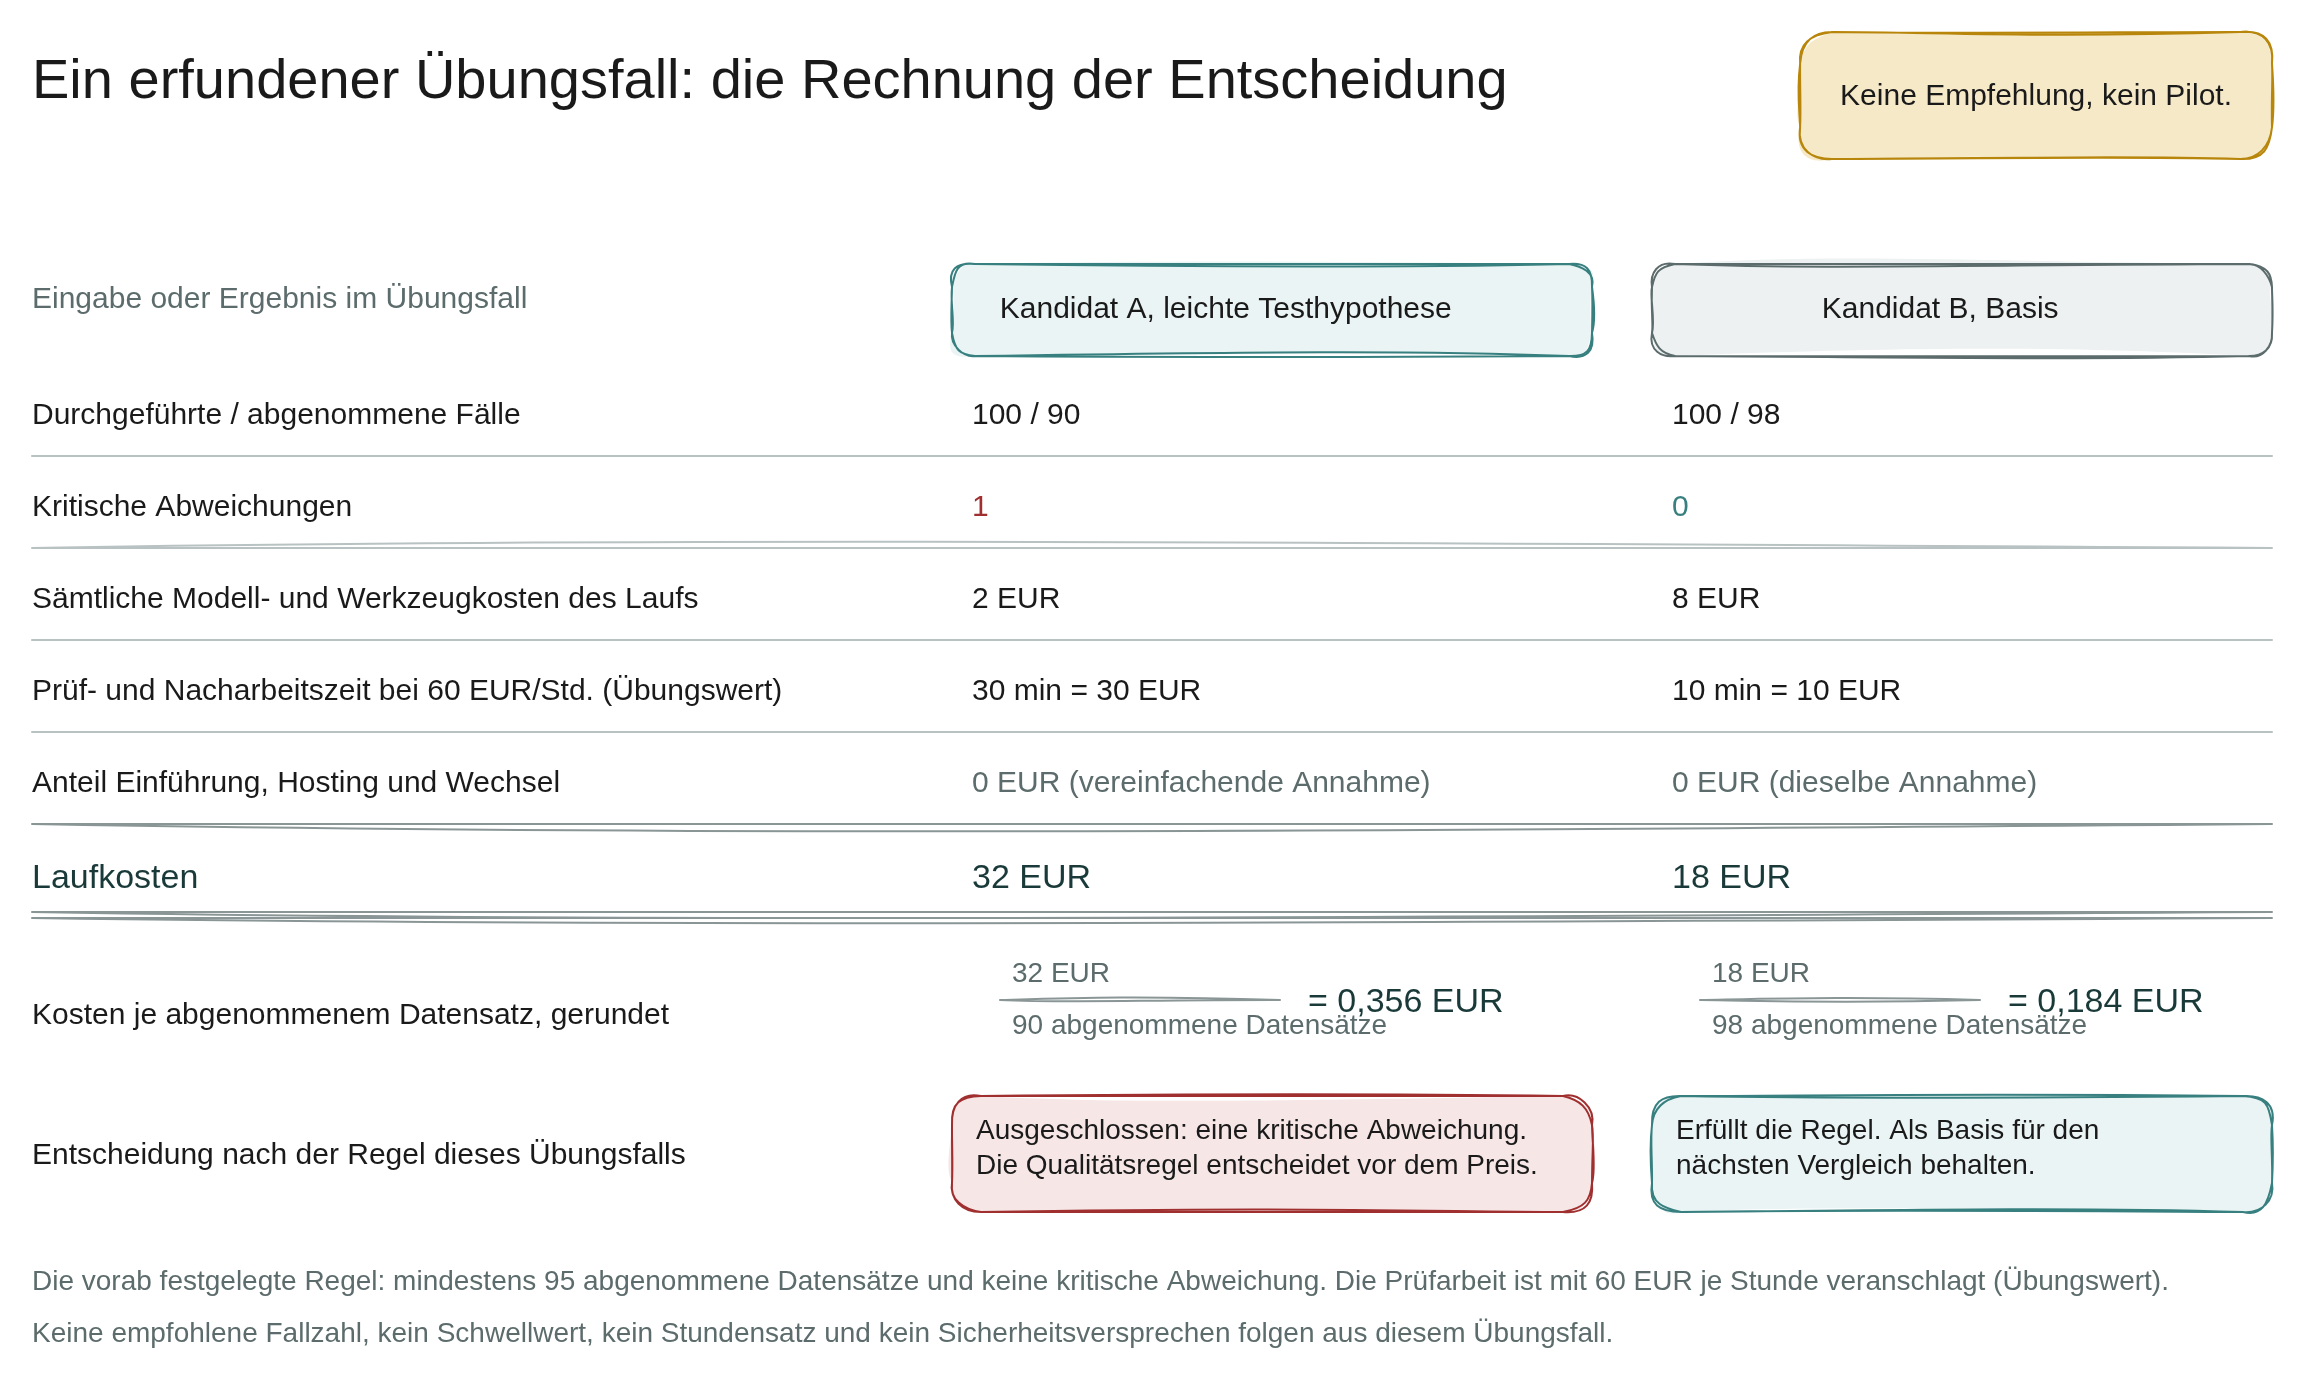 Der Übungsfall vollständig: beide Konfigurationen auf denselben 100 Bestellbelegen, ihre Laufkosten und ihre Kosten je abgenommenem Datensatz, darunter die Entscheidungszeile.
Nicht die Rechnung zählt, sondern Definition und Reihenfolge der Entscheidung: A verursacht geringere Modell- und Werkzeugkosten und verliert trotzdem, denn sein höherer Prüfaufwand macht den Lauf und jeden abgenommenen Datensatz teurer. Dass B diese Regel erfüllt, ist kein Beleg, dass B zu Ihrer Arbeit passt; es rechtfertigt lediglich einen weiteren kontrollierten Vergleich. Nicht abgenommene Ergebnisse bleiben in der Fehlerliste des Blatts, und alle Kosten für gescheiterte Versuche bleiben in der Kostenrechnung. In einem echten Prüfblatt tragen Sie statt der Null die tatsächlichen Kosten für Einführung, Betrieb und Wechsel ein.
Rechnen Sie je abgenommener Einheit
Bevor sich die Frage beantwortet, ob gewechselt wird, müssen Sie die Kosten beider Kandidaten auf derselben Grundlage berechnen. Aus den auf dem Blatt festgehaltenen Beobachtungen wird eine vergleichbare Zahl: die Gesamtkosten je abgenommener Einheit, eine schlichte betriebswirtschaftliche Festlegung, kein Kennzahlenversprechen eines Anbieters.
Gesamtkosten je abgenommener Einheit = (Modellkosten für alle Versuche + Anteil für Werkzeuge und Betrieb + Kosten für menschliche Prüfung und Nacharbeit + Anteil für Einführung und Wechsel) / Anzahl der abgenommenen Einheiten nach Ihren vorher festgelegten Kriterien
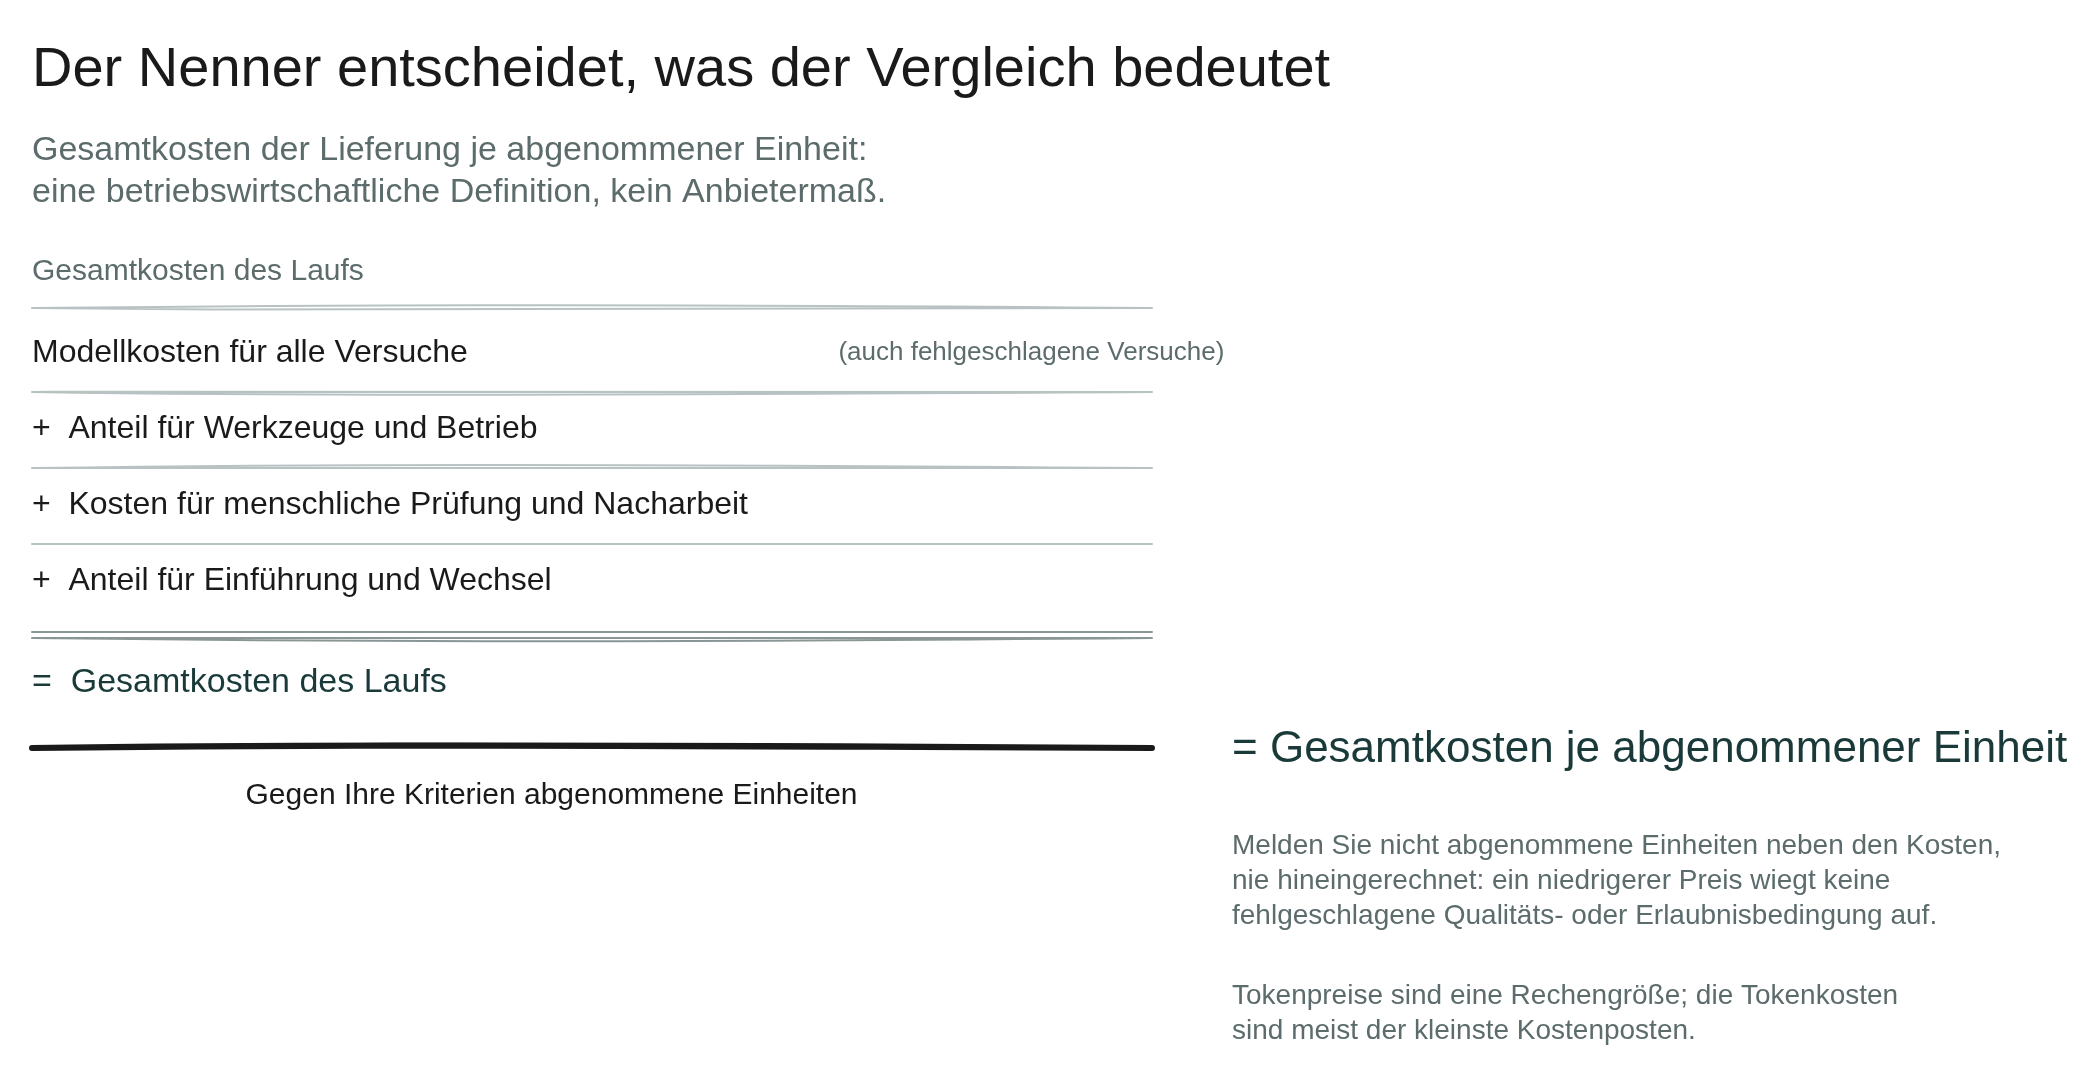 Die Berechnung auf dem Vergleichsblatt: die Gesamtkosten des Laufs geteilt durch die Anzahl der abgenommenen Einheiten. Die Kosten fehlgeschlagener Versuche stehen im Zähler; die Zahl nicht abgenommener Einheiten wird separat ausgewiesen und nicht in den Nenner aufgenommen.
Drei Regeln halten diese Zahl prüfbar. Der Nenner ist die Anzahl der abgenommenen Einheiten, nicht die Zahl der Versuche, damit eine Konfiguration, die viele Ergebnisse liefert, von denen nur wenige abgenommen werden, nicht billig aussieht. Die Kosten gescheiterter Versuche gehören in den Zähler, und nicht erfüllte Qualitäts- oder Erlaubnisbedingungen werden neben den Kosten ausgewiesen, nicht als Abschlag verrechnet: Ein niedriger Einheitspreis gleicht sie nicht aus.
Schreiben Sie Einheit und Nenner neben die Zahl: Ein Preis je abgenommenem Datensatz ohne Fallzahl, ohne Prüfminuten und ohne Datum des Laufes ist eine Zahl, die niemand nachrechnen kann, auch Sie selbst in sechs Monaten nicht. Notieren Sie zu jedem aufbewahrten Vergleich Datum, Modellversion, Denkstufe, Token-Arten und Währung.
Sehen Sie auch, an welcher Stellschraube Sie drehen: Denkstufe, zusätzlicher Prüfschritt und Modellwechsel sind drei Experimente mit unterschiedlichen Kostenfolgen, und nur das dritte tauscht das Modell, das Sie einkaufen. Ob sich ein günstiger Prüfschritt für die Modellausgabe lohnt, ist eine andere Frage als die, ob das Modell die Arbeit schafft.
Der Kauf von API-Aufrufen (Anfragen über eine Programmierschnittstelle) und der Eigenbetrieb eines Modells haben unterschiedliche Kostenstrukturen: Bei API-Aufrufen zahlen Sie für die Nutzung; beim Eigenbetrieb müssen Sie Kapazität bereitstellen, das System pflegen und Ausfälle verantworten. Keines davon ist automatisch die günstigere Antwort, und die Lizenz des Modells sagt nichts darüber, welche der beiden Betriebsformen Sie wählen.
Eine Lizenz ist kein Hosting-Vertrag
Nehmen Sie eine Modellkarte als Beispiel. Im Repository des Herausgebers liegt zu GLM-5.3-Flash eine MIT-Lizenz: Nutzung, Änderung und Weitergabe sind erlaubt, solange der Hinweis erhalten bleibt, und die Software wird ohne Gewährleistung bereitgestellt (Lizenztext). Das ist die Erlaubnis, den Code zu benutzen. Es ist keine Aussage darüber, wo Ihre Eingaben verarbeitet werden, wer den Dienst betreibt, welchen Vertrag Sie abschließen oder welche Aufsicht greift; für andere offene Modelle gelten andere Bedingungen.
Dieselbe Karte beschreibt insgesamt 320 Milliarden Parameter, davon 18 Milliarden aktive (Modellkarte). Keine der beiden Zahlen sagt, was nötig ist, um das Modell zu speichern oder zu betreiben: Welche Hardware Sie benötigen, lässt sich daraus nicht ablesen, und die Zahl aktiver Parameter ist kein Maß für den erforderlichen Betriebsaufwand.
Vier Fragen sollten Sie bei der Beschaffung für Ihren konkreten Einsatz klären. Wo werden Eingaben und Ausgaben verarbeitet und gespeichert, und unter welchem Auftragsverarbeitungsvertrag? Wer betreibt den Dienst und pflegt ihn? Wer trägt den Schaden, wenn das Ergebnis falsch ist, und was kostet Sie das? Wie prüfen Sie den Modellwechsel, bevor Sie ihn brauchen? Das ist eine Prüfliste für die Beschaffung, keine Rechtsberatung; sie ersetzt keine Zertifizierung des Betriebs.
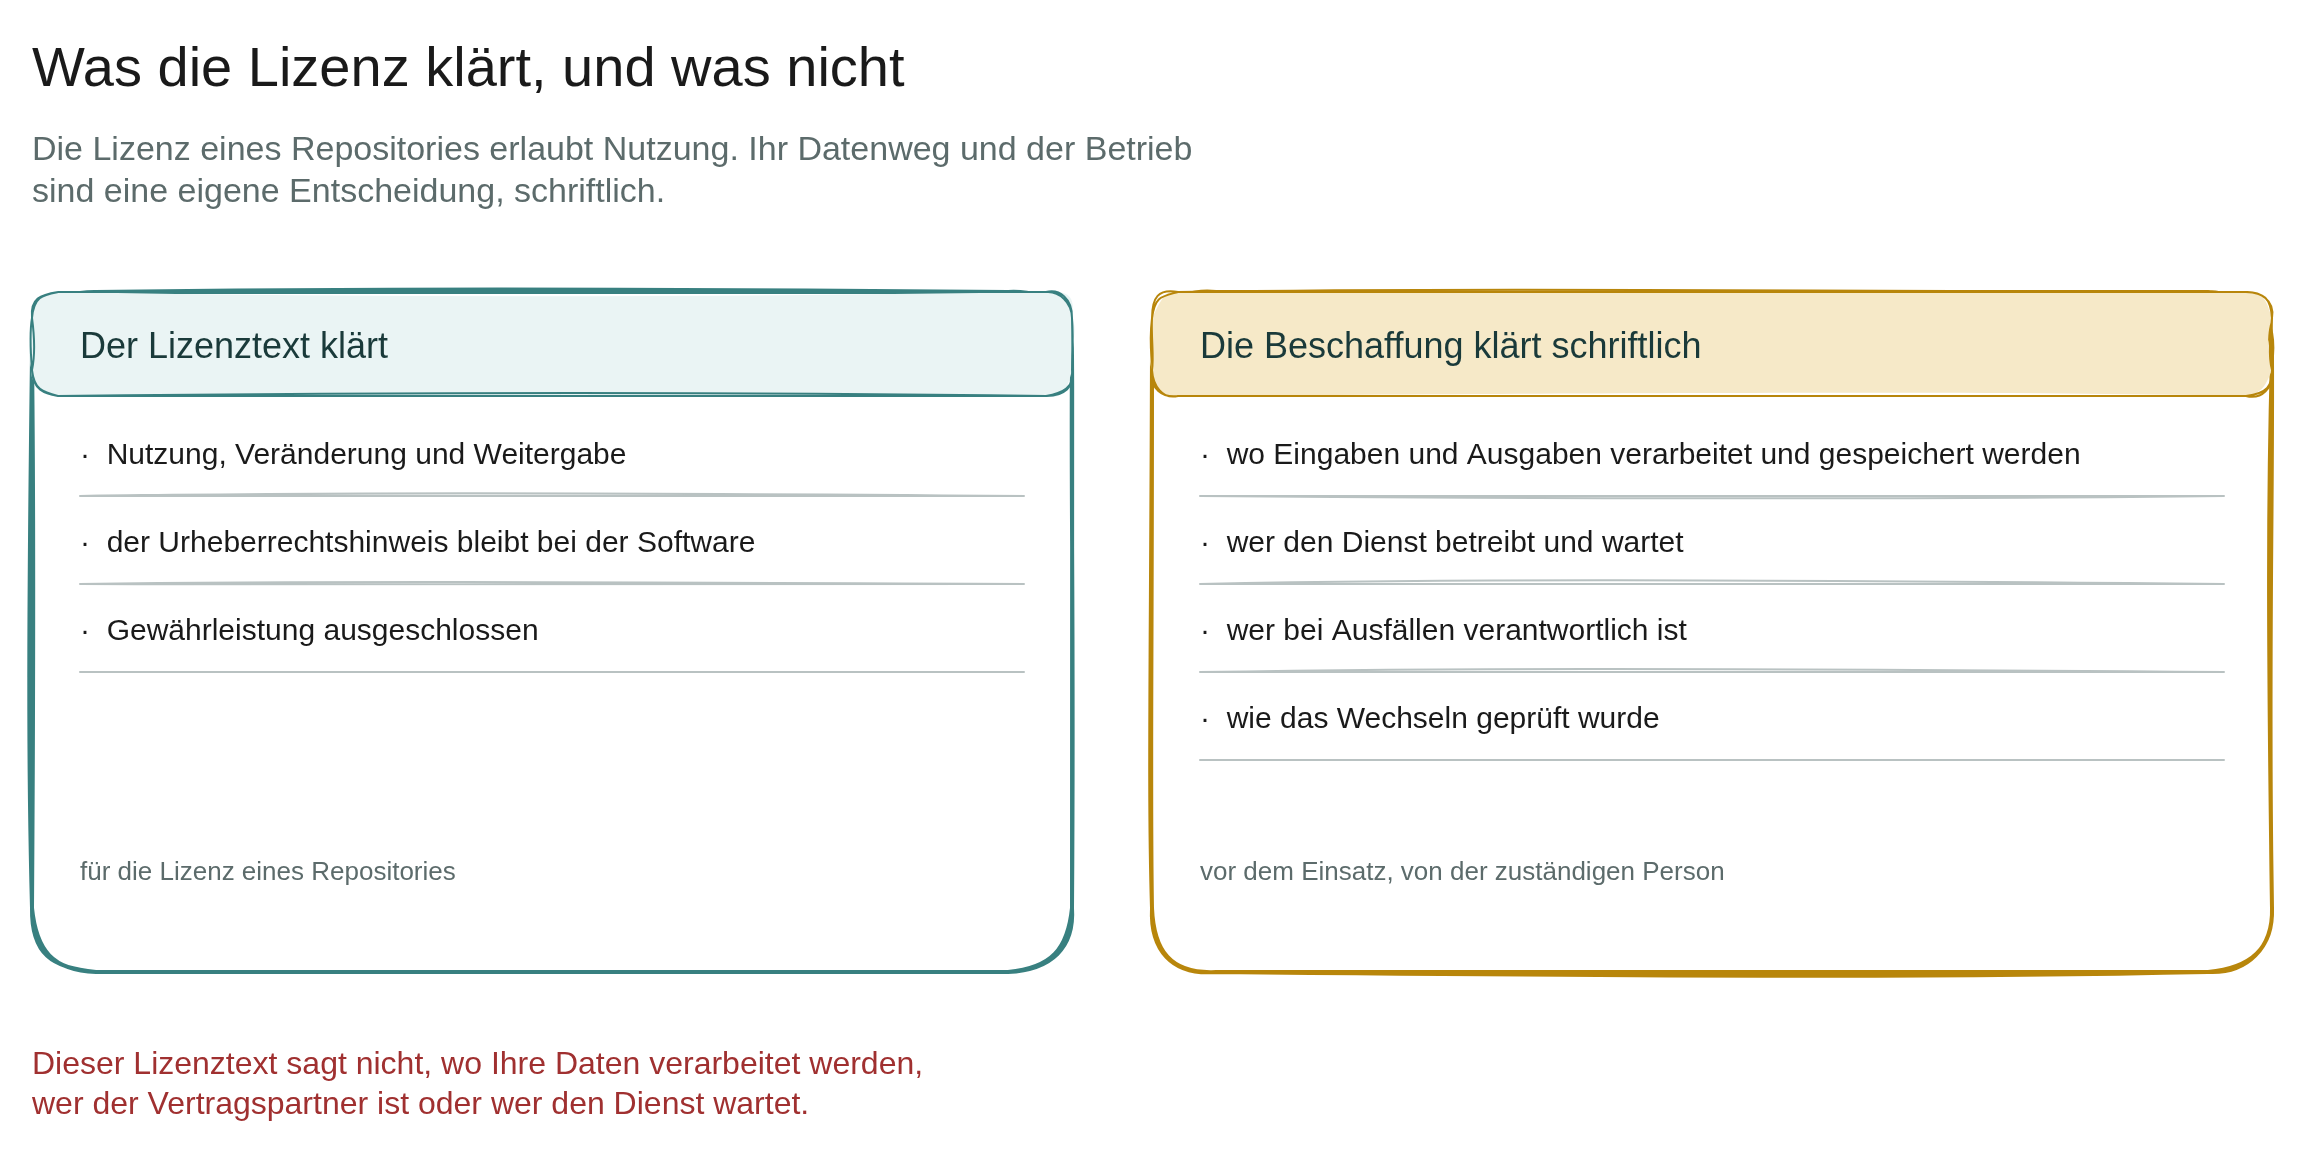 Eine Lizenz regelt, wie Sie die Inhalte eines Repositorys nutzen dürfen. Wo Daten verarbeitet werden, wer den Dienst betreibt und wie ein Modellwechsel vorab getestet wird, sind gesonderte Fragen, die vor dem Einsatz schriftlich beantwortet werden müssen.
Drei Fragen für das Entscheidungsgespräch
Die ganze Methode lässt sich in drei Fragen für das Gespräch zusammenfassen, das wirklich etwas entscheidet: ob gewechselt wird und auf welcher Grundlage. Stellen Sie sie einem Anbieter oder Ihrem eigenen Team.
- Welche Konfiguration bewältigt die konkret festgelegte Aufgabe, was zählt als abgenommene Arbeit, und welcher Nachweis anhand derselben Eingaben zeigt, dass eine leichte Konfiguration scheitert?
- Was kostet eine abgenommene Einheit, einschließlich der Kosten für gescheiterte Versuche, Werkzeuge, Betrieb, Prüfung, Nacharbeit und Wechsel, und welche Fehler bleiben, und welche davon sind kritisch?
- Wo werden Daten verarbeitet und gespeichert, wer verantwortet die Prüfung und den Umgang mit Ausnahmen, und was löst Eskalation, die Rückkehr zur bisherigen Konfiguration oder einen neuen Vergleich aus, wenn sich Modell, Bedingungen, Preis oder Aufgabe ändern?
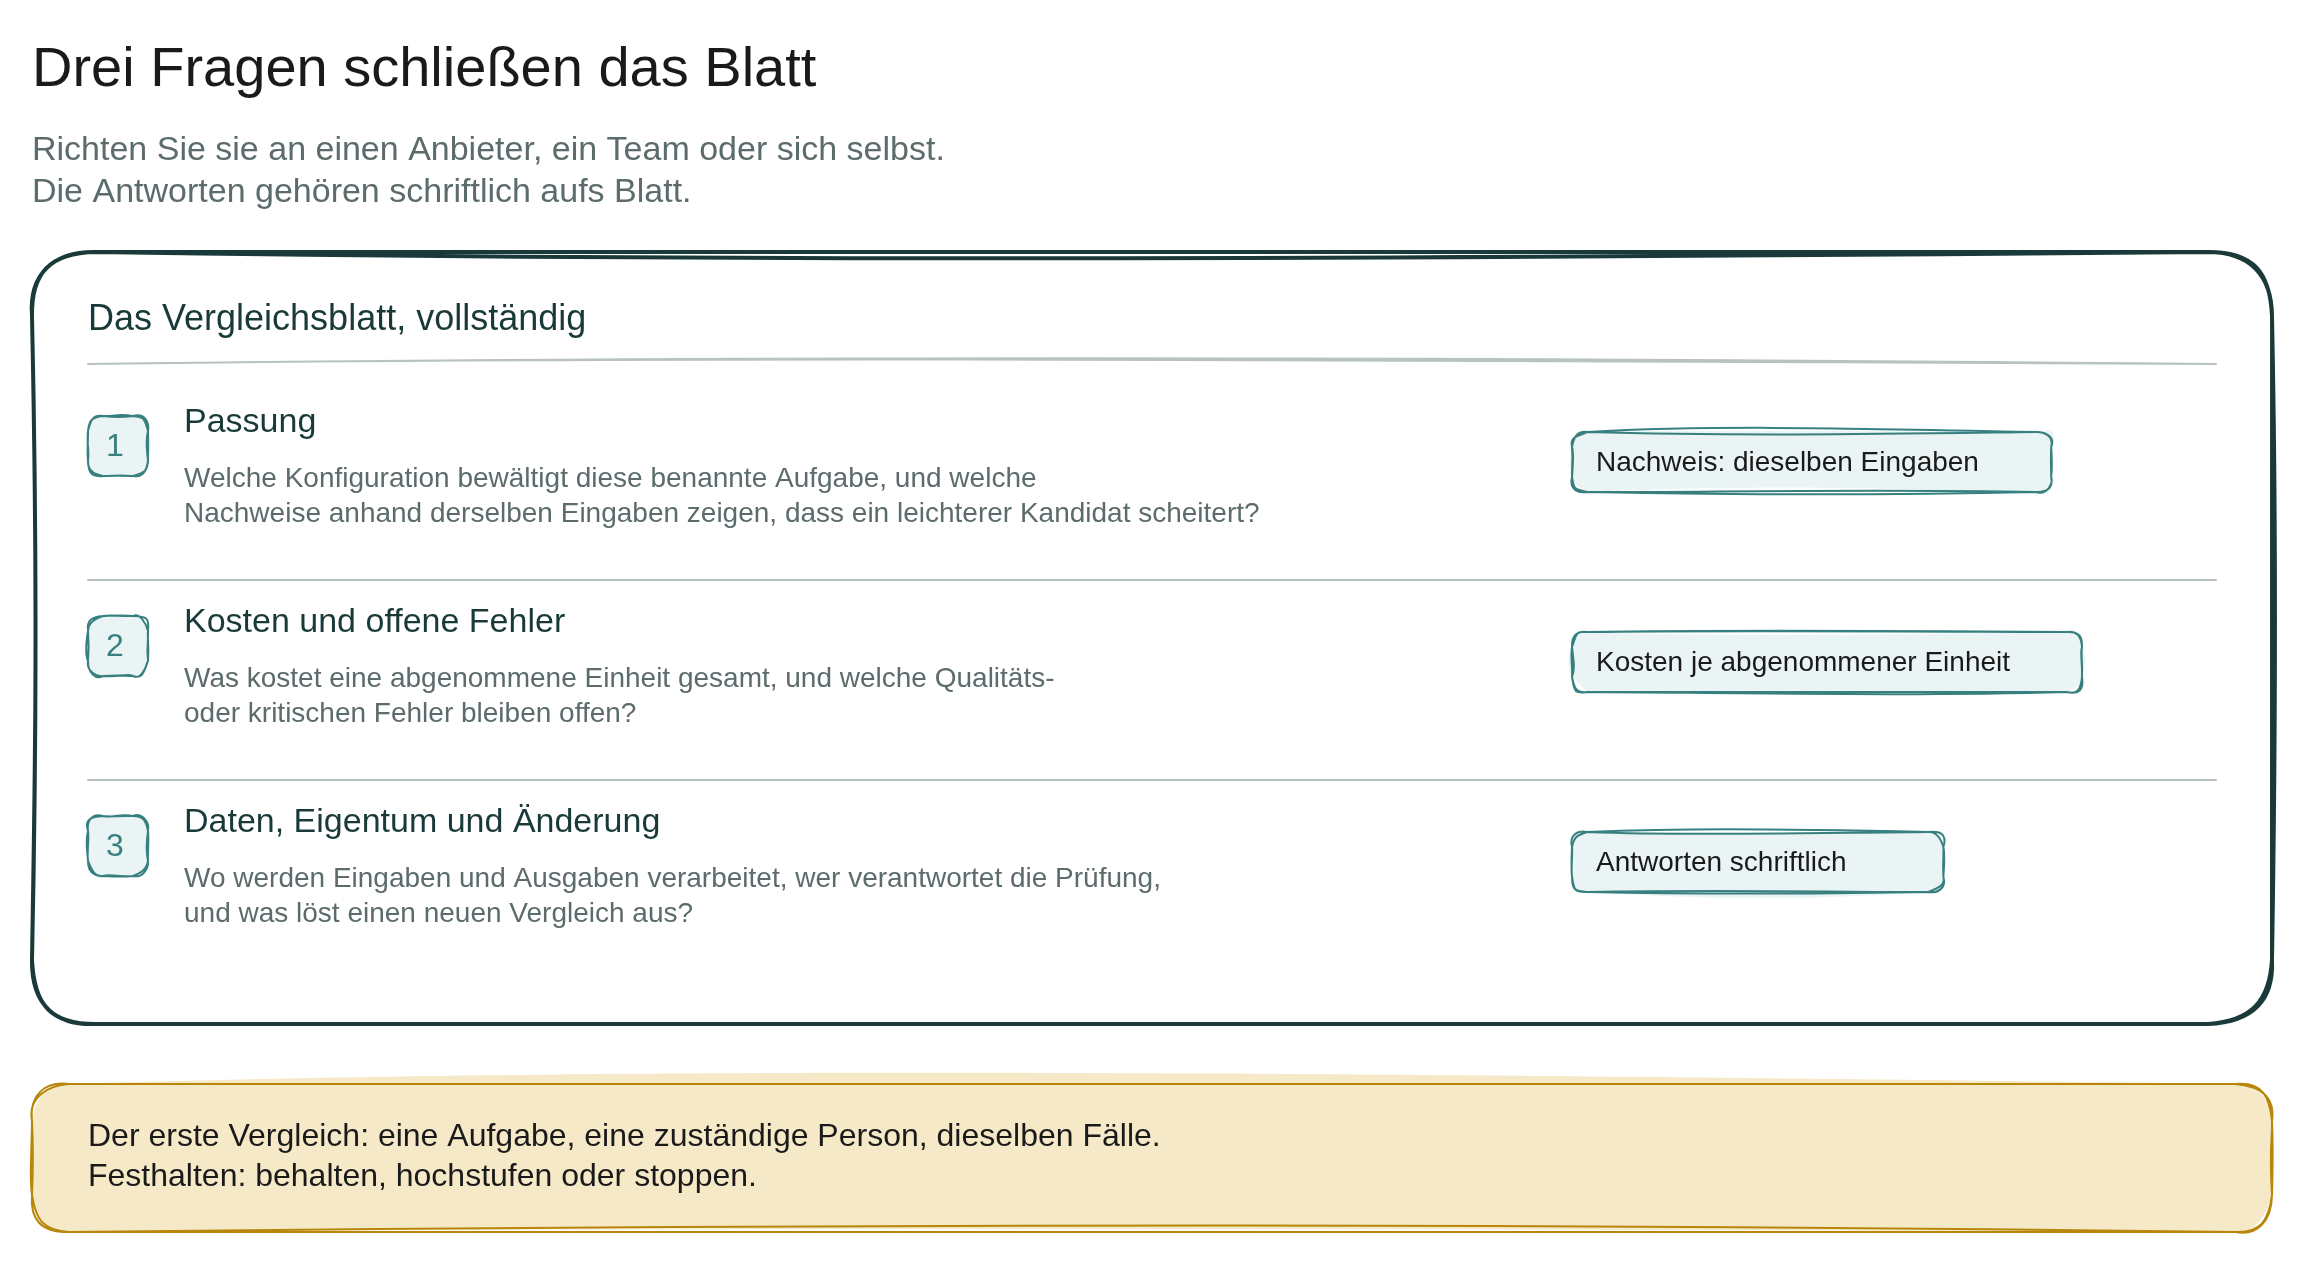 Drei Beschaffungsfragen schließen das Blatt ab. Der erste Vergleich darunter ist klein: eine Aufgabe, eine zuständige Person, dieselben Fälle und eine festgehaltene Entscheidung.
Der nächste Schritt ist kleiner als ein Projekt. Nennen Sie Aufgabe und verantwortliche Person, schreiben Sie abgenommene Einheit und Fehlerregeln auf eine Seite, sammeln Sie zulässige repräsentative Fälle, vergleichen Sie eine leichte Konfiguration mit der Baseline an denselben Fällen und tragen Sie das Ergebnis ein: behalten, hochstufen, stoppen. Wiederholen Sie das, wenn sich die Aufgabe, die Modellversion oder die Bedingungen ändern oder sich der Preis deutlich verändert.
Wenn Sie dieses erste Blatt mit jemandem entwickeln möchten, der solche Vergleiche schon gemacht hat: Die Planung und Auswertung solcher Vergleiche gehört zur Beratungsarbeit von evonomics. Die Verlängerung kann warten, bis diese eine Seite steht.